NVIDIA RTX PRO 6000 Blackwell MAX-Q 96GB GPU 서버 호스팅 안내
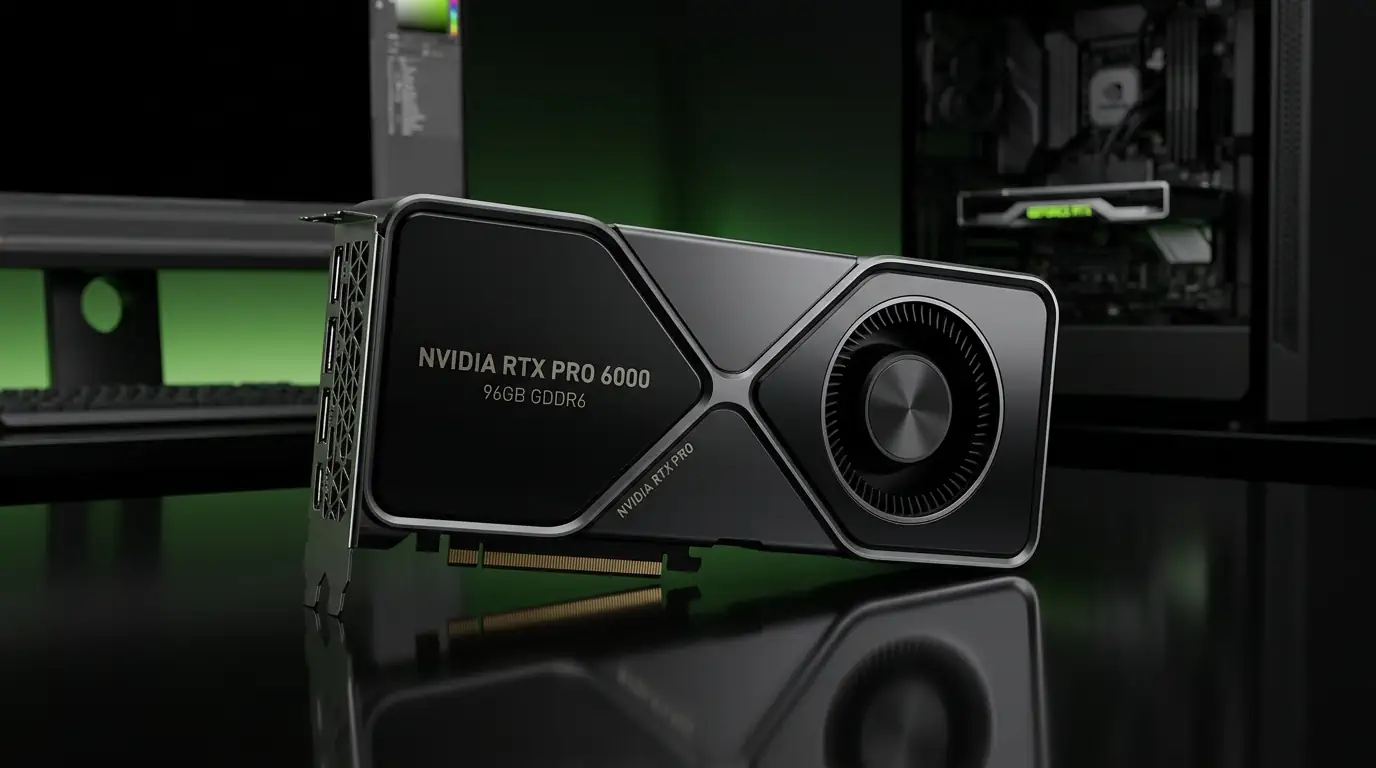
MyIP.co.kr 数据中心直接运营的 NVIDIA RTX PRO 6000 Blackwell MAX-Q 96GB 专用裸金属 GPU 服务器。配备 96GB GDDR7 ECC 显存、24,064 CUDA 核心、752 个第五代 Tensor 核心 (支持 FP4) 的企业级工作站 GPU。特别适合数据中心高密度部署、风冷环境、桌面侧多 GPU 推理服务器。
■ 主要硬件规格
| GPU 型号 | NVIDIA RTX PRO 6000 Blackwell MAX-Q 96GB |
|---|
| 架构 | Blackwell Pro (GB202) |
|---|
| CUDA 核心 | 24,064 |
|---|
| Tensor 核心 | 752 (第五代, FP4) |
|---|
| RT 核心 | 188 (第四代) |
|---|
| 显存 | 96 GB GDDR7 ECC |
|---|
| 显存带宽 | 1,792 GB/s |
|---|
| FP32 性能 | 110+ TFLOPS |
|---|
| 外形规格 | 双槽涡轮散热·主动冷却·长度 10.5 英寸 |
|---|
| 接口 | PCIe Gen5 x16 · MIG · ECC |
|---|
| 基础服务器 | Intel Xeon Silver 4110 / E5-2650L · 64GB RAM · 512GB NVMe |
|---|
| 流量 | 每月 5TB 免费 (超出部分每 GB 40 韩元) |
|---|
■ MAX-Q 版本的差异化
- 工作站涡轮散热 - 前进后出的涡轮散热器允许多 GPU 密集部署,适用于 1U/2U 服务器及 2-4 路工作站。
- 相同 96GB ECC 显存 - 显存容量、带宽、ECC 与完整版完全一致。LLM 70B+ 推理和微调可直接运行。
- MIG 虚拟化支持 - 将单块 GPU 分割为最多 4-7 个实例,用于多租户推理服务。
■ 适用场景
- LLM 推理服务商 - 通过 vLLM、TGI、TensorRT-LLM 部署 Llama 3 70B / Qwen2.5 72B / Mixtral 8x22B 等大模型
- AI 创业公司 - 基础模型微调 (LoRA/QLoRA/Full) 和 RAG 基础设施
- 共享推理平台 - 基于 MIG 的多租户推理平台,GPU 即服务业务
- 企业 AI 研发 - 企业内 LLM 本地部署、大规模数据集训练、数字孪生与 HPC
- 视频生成工作室 - Sora 级视频生成、高分辨率 Stable Video Diffusion、3D 渲染
■ 支持的最新 AI 模型与应用
在 CUDA 12.x / cuDNN / PyTorch 2.x 环境中自由运行 2025-2026 最新开源模型。从 Hugging Face / CivitAI 下载检查点,使用 ComfyUI、Automatic1111 WebUI、text-generation-webui、vLLM、Ollama 等首选运行器即刻启动。
图像生成 (Image Generation)
- FLUX.1 (Black Forest Labs) - FLUX.1 [dev]、[schnell]、Pro 模型。照片级真实感,手部和文字渲染精度无与伦比
- Stable Diffusion 3 / SDXL / SD 1.5 - 完全兼容传统 LoRA 生态,支持 ControlNet · IP-Adapter · Regional Prompter 等
- Z-image - 最新社区多模态图像模型
- ComfyUI - 节点可视化工作流构建器,自动化复杂管线(升采样 · 换脸 · 修复 · AnimateDiff)
视频生成 (Video Generation)
- Wan (阿里巴巴) - 高品质视频 · 图像模型
- LTX-Video (Lightricks) - 实时视频生成,低延迟推理优化
- MiniMax H3 - 顶级视频生成
- 支持 文本到视频 · 图像到视频 · 姿态控制 · 相机轨迹控制
AI 剧集 / 短视频内容生成
- 剧本(LLM) → 角色设计(FLUX) → 场景视频(LTX / Wan) → 配音(TTS) → 字幕(Whisper) 全链路
- ComfyUI 工作流完全自动化 - 一个提示词生成完整短视频/剧集
- 可用于 YouTube Shorts、抖音、Instagram Reels、网剧制作
LLM 推理 (Inference)
- Qwen 3 (阿里巴巴通义) - 多语言 · 多模态 · 代码 · 数学专精,开源权重
- Llama 3.3 / 70B (Meta) - 通用对话与编程
- DeepSeek V3 / R1 - 推理(reasoning) 专精,OpenAI o1 级性能
- Mixtral 8x22B、Mistral Large - MoE 架构
- 可通过 vLLM · TGI · Ollama · text-generation-webui · llama.cpp 本地部署
音乐 · 音频生成
- Stable Audio (Stability AI) - 本地音乐生成,支持流派 · BPM · 氛围条件
- MusicGen (Meta) - 旋律条件音乐生成
- AudioLDM 2 - 语音 · 音效 · 背景音乐统一生成
- Bark · XTTS v2 - 多语言 TTS、音色克隆、情感表达
- Whisper Large v3 - 100+ 语言自动字幕生成
■ 基础包含服务
- 月付 (随时取消)
- 包含 1 个固定 IPv4
- SSH / root 密码访问
- 带宽: 1G / 1000Mbps
- 每月 5TB 流量 (1Gbps 端口)
- 可选预装 CUDA 12.x + cuDNN + PyTorch 2.x 环境
- 开通时间: 1-3 个工作日
■ FAQ
Q1. 是裸金属还是虚拟化?
100% 裸金属专用服务器。物理 GPU 由您独占使用,可自行配置 MIG 分区运行自己的多租户。
Q2. 能运行 70B 级大模型吗?
96GB 显存可直接以 FP16/BF16 加载 Llama 3 70B / Qwen2.5 72B。使用 INT4/AWQ 量化时,可通过 2 块 GPU 部署 Llama 3 405B。
Q3. 可以增加内存或存储吗?
可以。结账时可升级到 128GB 内存 (+150,000 韩元/月) 或 NVMe 1TB (+40,000 韩元/月) 或 NVMe 2TB (+80,000 韩元/月)。
Q4. 超过每月 5TB 流量会怎样?
超出部分每 GB 收取 40 韩元。服务不会中断,每月 1 日重置。
MyIP.co.kr - 运营 15 年的韩国托管专业服务商。企业 GPU 服务器咨询: 工作日 09:00~18:00 KST