NVIDIA RTX PRO 6000 Blackwell MAX-Q 96GB GPU 서버 호스팅 안내
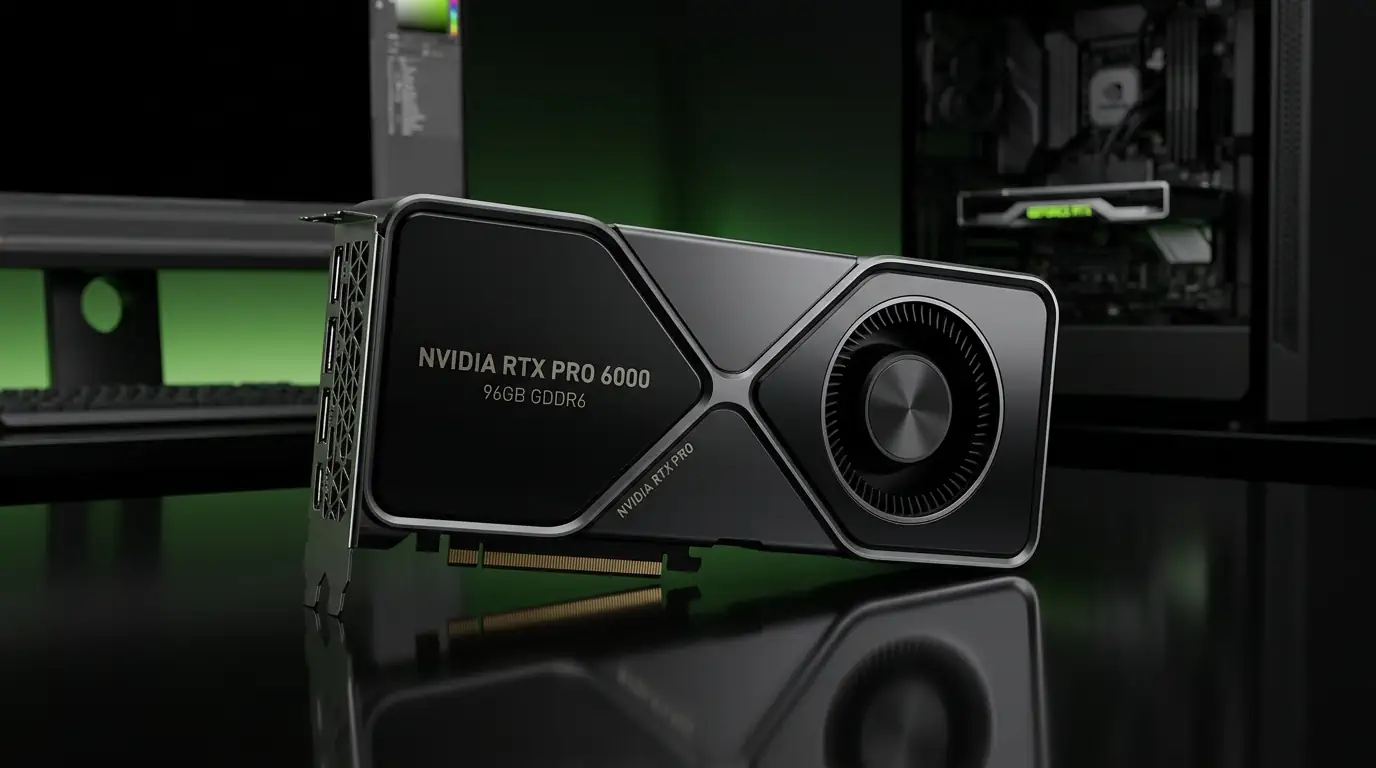
MyIP.co.kr データセンターが直接運営する NVIDIA RTX PRO 6000 Blackwell MAX-Q 96GB 専用ベアメタル GPU サーバーです。96GB GDDR7 ECC VRAM、24,064 CUDA コア、752 の第 5 世代 Tensor コア (FP4 対応) を搭載したエンタープライズ級ワークステーション GPU です。データセンターの高密度配置、エアクーリング環境、デスクサイドのマルチ GPU 推論サーバーに特に適しています。
■ 主なハードウェアスペック
| GPU モデル | NVIDIA RTX PRO 6000 Blackwell MAX-Q 96GB |
|---|
| アーキテクチャ | Blackwell Pro (GB202) |
|---|
| CUDA コア | 24,064 |
|---|
| Tensor コア | 752 (第 5 世代, FP4) |
|---|
| RT コア | 188 (第 4 世代) |
|---|
| VRAM | 96 GB GDDR7 ECC |
|---|
| メモリ帯域幅 | 1,792 GB/s |
|---|
| FP32 性能 | 110+ TFLOPS |
|---|
| フォームファクタ | デュアルスロット・ブロワー・アクティブ冷却・全長 10.5 インチ |
|---|
| インターフェース | PCIe Gen5 x16 · MIG · ECC |
|---|
| ベースサーバー | Intel Xeon Silver 4110 / E5-2650L · 64GB RAM · 512GB NVMe |
|---|
| トラフィック | 月 5,000GB 無料 (超過分 1GB あたり 40 ウォン) |
|---|
■ MAX-Q バリアントの違い
- ワークステーションブロワー冷却 - 前面吸気・背面排気のブロワーでマルチ GPU を密接配置可能。1U/2U サーバーや 2-4way ワークステーション向け。
- 同じ 96GB ECC VRAM - VRAM 容量・帯域幅・ECC は上位モデルと完全同一。LLM 70B+ 推論・ファインチューニングはそのまま実行可能。
- MIG 仮想化対応 - 1 枚の GPU を最大 4-7 インスタンスに分割し、マルチテナント推論サービングに活用可能。
■ こんな方におすすめ
- LLM 推論サービング事業者 - Llama 3 70B / Qwen2.5 72B / Mixtral 8x22B 等の大型モデルを vLLM・TGI で配信
- AI スタートアップ - ファウンデーションモデルのファインチューニング (LoRA/QLoRA/Full) と RAG 基盤
- データセンター共用推論プラットフォーム - MIG ベースのマルチテナント推論、GPU 仮想化レンタル
- エンタープライズ AI R&D - 社内 LLM オンプレミス展開、大規模データセット学習、デジタルツイン・科学計算
- 動画生成スタジオ - Sora 系の動画生成、高解像度 Stable Video Diffusion、3D レンダリング
■ 対応する最新 AI モデルと活用
CUDA 12.x · cuDNN · PyTorch 2.x 環境で 2025-2026 の最新オープンソースモデルを自由に実行できます。Hugging Face · CivitAI からチェックポイントをダウンロードし、ComfyUI、Automatic1111、text-generation-webui、vLLM、Ollama などお好みのランナーで即起動可能です。
画像生成 (Image Generation)
- FLUX.1 (Black Forest Labs) - FLUX.1 [dev]、[schnell]、Pro。写真級リアリズム、手やテキストのレンダリング精度が圧倒的
- Stable Diffusion 3 / SDXL / SD 1.5 - レガシー LoRA エコシステム対応、ControlNet · IP-Adapter · Regional Prompter 等全部使用可能
- Z-image - 最新コミュニティマルチモーダル画像モデル
- ComfyUI - ノードベースのビジュアルワークフロービルダー。複雑なパイプライン(アップスケール · 顔スワップ · インペイント · AnimateDiff)の自動化
動画生成 (Video Generation)
- Wan (Alibaba) - 高品質な動画・画像モデル
- LTX-Video (Lightricks) - リアルタイム動画生成、低遅延推論最適化
- MiniMax H3 - 最高級の映像生成が可能
- Text-to-Video · Image-to-Video · ポーズ制御 · カメラ軌道制御すべて対応
AI ドラマ / ショート動画コンテンツ生成
- スクリプト(LLM) → キャラクターデザイン(FLUX) → シーン動画(LTX / Wan) → 音声(TTS) → 字幕(Whisper) 統合パイプライン
- ComfyUI ワークフローで完全自動化可能 - プロンプト一つで完成形ショートやドラマを生成
- YouTube Shorts、TikTok、Instagram Reels、Web ドラマ制作に活用
LLM 推論 (Inference)
- Qwen 3 (Alibaba Tongyi) - 多言語 · マルチモーダル · コード · 数学特化、公開ウェイト
- Llama 3.3 / 70B (Meta) - 汎用対話 · コーディング
- DeepSeek V3 / R1 - 推論(reasoning)特化、OpenAI o1 級の性能
- Mixtral 8x22B、Mistral Large - MoE アーキテクチャ
- vLLM · TGI · Ollama · text-generation-webui · llama.cpp 全てローカルサービング可能
音楽 · 音声生成
- Stable Audio (Stability AI) - ローカル音楽生成、ジャンル · BPM · 雰囲気条件付け
- MusicGen (Meta) - メロディ入力条件付き音楽生成
- AudioLDM 2 - 音声 · 効果音 · BGM の統合生成
- Bark · XTTS v2 - 多言語 TTS、音声クローン、感情表現
- Whisper Large v3 - 100+ 言語の自動字幕生成
■ 基本含まれるサービス
- 月額課金 (いつでも解約可能)
- 固定 IP 1 個付き
- SSH / root パスワード提供
- 回線帯域幅: 1G / 1000Mbps
- 月 5TB トラフィック無料 (1Gbps ポート)
- CUDA 12.x + cuDNN + PyTorch 2.x プリインストールオプション
- 開通所要時間 1~3 営業日
■ FAQ
Q1. ベアメタルですか?仮想化ですか?
100% ベアメタル専用サーバーです。GPU パススルー仮想化ではなく物理 GPU を独占使用でき、MIG 分割は顧客が自身で設定してテナンシーを運用可能です。
Q2. LLM 70B 級モデルも動きますか?
96GB VRAM で Llama 3 70B / Qwen2.5 72B を FP16/BF16 のままロード可能です。INT4/AWQ 量子化で Llama 3 405B を 2 枚構成でサービング可能です。
Q3. メモリやストレージの追加は?
はい。128GB RAM (+150,000 ウォン/月) または NVMe 1TB (+40,000 ウォン/月) または NVMe 2TB (+80,000 ウォン/月) をご注文時に選択できます。
Q4. 月 5TB トラフィックを超過したら?
超過分は 1GB あたり 40 ウォンで課金されます。サービス中断はありません。毎月 1 日にリセットされます。
MyIP.co.kr - 15 年間運営の信頼できる韓国ホスティング専門業者。エンタープライズ GPU サーバー相談: 平日 09:00~18:00 KST