NVIDIA RTX PRO 6000 Blackwell MAX-Q 96GB GPU 서버 호스팅 안내
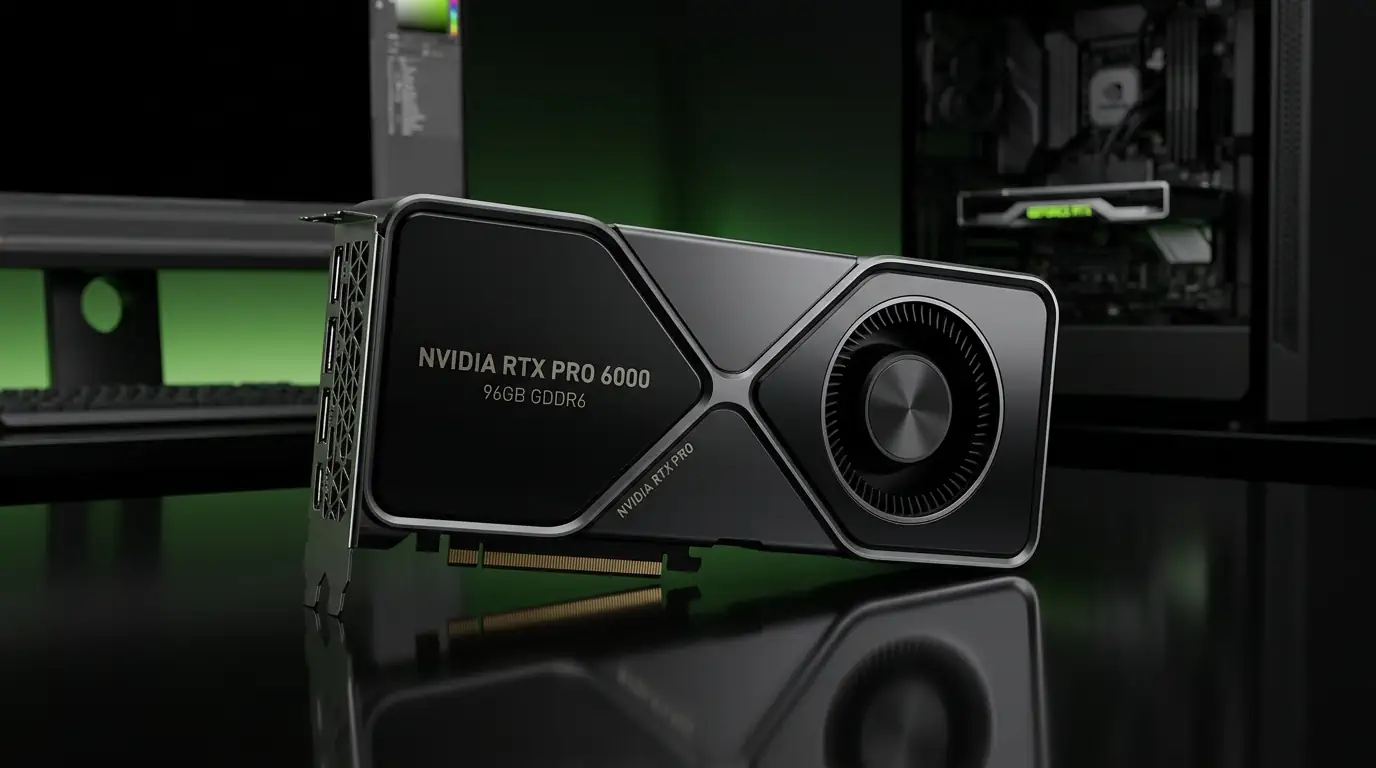
MyIP.co.kr 데이터센터에서 직접 운영하는 NVIDIA RTX PRO 6000 Blackwell MAX-Q 96GB 전용 베어메탈 GPU 서버입니다. 96GB GDDR7 ECC VRAM, 24,064 CUDA 코어, 752개 5세대 Tensor 코어(FP4 지원)를 탑재한 엔터프라이즈급 워크스테이션 GPU입니다. 데이터센터 밀도 집적, 에어쿨링 환경, 다중 GPU 데스크사이드 추론 서버에 특히 적합합니다.
국내에서 최고 사양의 RTX PRO 6000 임대 서비스를 제공합니다. 수천만 원대의 장비 구매 부담 없이 월 과금 기반의 RTX PRO 6000 렌탈로 즉시 투입하실 수 있으며, 전용 서버 환경에서 24시간 안정적인 RTX PRO 6000 호스팅을 지원합니다. LLM 학습·추론, AI 영상 생성, 3D 렌더링, 디지털 트윈 등 96GB VRAM 이 필요한 모든 고성능 GPU 작업에 최적화되어 있습니다.
■ 주요 하드웨어 스펙
| GPU 모델 | NVIDIA RTX PRO 6000 Blackwell MAX-Q 96GB |
|---|
| 아키텍처 | Blackwell Pro (GB202) |
|---|
| CUDA 코어 | 24,064 |
|---|
| Tensor 코어 | 752 (5세대, FP4) |
|---|
| RT 코어 | 188 (4세대) |
|---|
| VRAM | 96 GB GDDR7 ECC |
|---|
| 메모리 대역폭 | 1,792 GB/s |
|---|
| FP32 성능 | 110+ TFLOPS |
|---|
| 폼팩터 | 듀얼 슬롯 블로워 · 액티브 쿨링 · 전장 10.5인치 |
|---|
| 인터페이스 | PCIe Gen5 x16 · MIG · ECC |
|---|
| 기본 서버 | Intel Xeon Silver 4110 / E5-2650L · 64GB RAM · 512GB NVMe |
|---|
| 기본 트래픽 | 월 5,000GB 무료 (초과분 1GB당 40원 과금) |
|---|
■ MAX-Q 변형의 차별점
- 워크스테이션 블로워 쿨러 - 전면 흡기·후면 배기 블로워로 멀티 GPU 밀착 배치가 가능. 1U/2U 서버 및 2-4way 워크스테이션 적합.
- 동일한 96GB ECC VRAM - 상위 모델과 동일한 VRAM 용량·대역폭·ECC를 유지. LLM 70B+ 추론·파인튜닝 그대로 수행 가능.
- MIG 가상화 지원 - 하나의 GPU를 최대 4-7개 인스턴스로 분할하여 멀티 테넌시 추론 서빙에 활용 가능.
■ 이런 분들께 추천합니다
- LLM 추론 서빙 사업자 - Llama 3 70B / Qwen2.5 72B / Mixtral 8x22B 등 대형 모델을 vLLM·TGI로 서빙
- AI 스타트업 - 파운데이션 모델 파인튜닝 (LoRA/QLoRA/Full) 및 RAG 인프라
- 데이터센터 공유 추론 플랫폼 - MIG 기반 멀티 테넌시 추론 플랫폼, GPU 가상화 임대 사업
- 엔터프라이즈 AI R&D - 사내 LLM 온프레미스 배포, 대규모 데이터셋 학습, 디지털 트윈·과학 연산
- 영상 생성 스튜디오 - Sora계열 비디오 생성, 고해상도 Stable Video Diffusion, 3D 렌더링 파이프라인
■ 지원하는 최신 AI 모델 및 활용
CUDA 12.x · cuDNN · PyTorch 2.x 환경에서 2025~2026 최신 오픈소스 모델을 자유롭게 실행하실 수 있습니다. Hugging Face · CivitAI 에서 체크포인트를 받아 ComfyUI, Automatic1111 WebUI, text-generation-webui, vLLM, Ollama 등 선호 러너로 바로 구동 가능합니다.
이미지 생성 (Image Generation)
- FLUX.1 (Black Forest Labs) - FLUX.1 [dev], [schnell], Pro 모델. 사진급 리얼리즘, 손 · 텍스트 렌더링 정확도 압도적
- Stable Diffusion 3 / SDXL / SD 1.5 - 레거시 커스텀 LoRA 생태계 호환, ControlNet · IP-Adapter · Regional Prompter 등 전부 사용 가능
- Z-image - 최신 커뮤니티 멀티모달 이미지 모델
- ComfyUI - 노드 기반 비주얼 워크플로우 빌더. 복합 파이프라인(upscale · face-swap · inpaint · AnimateDiff) 자동화
영상 생성 (Video Generation)
- Wan (알리바바) - 고품질 비디오 · 이미지 모델
- LTX-Video (Lightricks) - 리얼타임 비디오 생성, 저지연 추론 최적화
- MiniMax H3 - 최상급 영상 생성 가능
- Text-to-Video · Image-to-Video · 포즈 제어 · 카메라 궤적 제어 모두 지원
AI 드라마 / 숏츠 콘텐츠 생성
- 스크립트(LLM) → 캐릭터 디자인(FLUX) → 장면 영상(LTX / Wan) → 음성(TTS) → 자막(Whisper) 통합 파이프라인
- ComfyUI 워크플로우로 완전 자동화 가능 - 프롬프트 하나로 완성형 숏츠/드라마 생성
- 유튜브 숏츠, 틱톡, 인스타그램 릴스, 웹드라마 제작에 활용
LLM 추론 (Inference)
- Qwen 3 (알리바바 Tongyi) - 다국어 · 멀티모달 · 코드 · 수학 특화, 공개 가중치
- Llama 3.3 / 70B (Meta) - 범용 대화 · 코딩
- DeepSeek V3 / R1 - 추론(reasoning) 특화, OpenAI o1 급 성능
- Mixtral 8x22B, Mistral Large - MoE 아키텍처
- vLLM · TGI · Ollama · text-generation-webui · llama.cpp 모두 로컬 서빙 가능
음악 / 오디오 생성
- Stable Audio (Stability AI) - 로컬 뮤직 생성, 장르 · BPM · 분위기 조건부
- MusicGen (Meta) - 멜로디 입력 조건부 음악 생성
- AudioLDM 2 - 음성 · 효과음 · 배경 음악 통합 생성
- Bark · XTTS v2 - 다국어 TTS, 음성 복제, 감정 표현
- Whisper Large v3 - 100+ 언어 자동 자막 생성
■ 기본 포함 서비스
- 월간 과금 (언제든 해지 가능)
- 고정 IP 1개 포함
- SSH / root 접속 패스워드 제공
- 회선 대역폭 : 1G / 1000Mbps
- 월 5TB 트래픽 무료 (1Gbps 포트)
- CUDA 12.x + cuDNN + PyTorch 2.x 사전 설치 옵션
- 개통 소요시간 1~3영업일
■ FAQ
Q1. 베어메탈인가요? 가상화인가요?
100% 베어메탈 전용 서버입니다. GPU 패스스루 가상화가 아닌 물리 GPU를 독점 사용하시며, MIG 분할은 고객이 직접 설정하여 테넌시를 운용할 수 있습니다.
Q2. LLM 70B 급 모델도 돌릴 수 있나요?
96GB VRAM이면 Llama 3 70B / Qwen2.5 72B 를 FP16 or BF16으로 그대로 로드 가능합니다. INT4/AWQ 양자화 시 Llama 3 405B를 2-GPU로 서빙하는 구성도 가능합니다.
Q3. 메모리나 저장공간을 더 추가할 수 있나요?
네. 주문 시 128GB DDR4 RAM (+150,000원/월), NVMe 1TB (+40,000원/월) 또는 NVMe 2TB (+80,000원/월) 업그레이드를 선택하실 수 있습니다. 추후 티켓으로도 변경 가능합니다.
Q4. 월 5TB 트래픽을 초과하면 어떻게 되나요?
초과분에 대해 1GB당 40원이 과금됩니다. 서비스 중단은 없으며, 매월 1일 사용량이 초기화됩니다. 10Gbps 비제한 트래픽 옵션 문의 가능합니다.
MyIP.co.kr - 15년간 운영된 신뢰할 수 있는 국내 호스팅 전문업체. 엔터프라이즈 GPU 서버 상담: 평일 09:00~18:00 KST